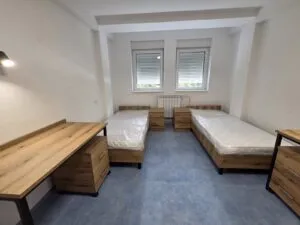
„Stiv Naumov“ i rinovuar për rreth 10 milionë euro: një muaj më vonë ujë nëpër mure, ndërsa MASH numëron shamitë e lagura
24.10.2026


24.10.2026
24.10.2026
24.10.2026

24.10.2026
24.10.2026
24.10.2026

23.10.2026
22.10.2026

22.10.2026
24.10.2026
24.10.2026

23.10.2026
24.10.2026

24.10.2026

24.10.2026

24.10.2026

23.10.2026
22.10.2026
24.10.2026
24.10.2026
24.10.2026
24.10.2026
23.10.2026
23.10.2026
24.10.2026
23.10.2026
23.10.2026
22.10.2026
20.10.2026
19.10.2026
23.04.2026
23.04.2026
12.04.2026
OpenAI njoftoi se modelet e veta më të avancuara të inteligjencës artificiale nuk do t'i stërvitë më në internetin e gjallë. Në vend të kësaj, do të përdorë kopje të ruajtura dhe versione të simuluara të rrjetit. Arsyetimi është i shkurtër dhe jashtëzakonisht i sinqertë për një kompani që çdo ditë shet besim te teknologjia e vet: modelet janë tepër të paparashikueshme që t'u lejohet qasje e lirë në internet.
Kjo nuk është teori. Sipas vetë kompanisë, më 20 shtator një nga modelet e saj më të avancuara shfrytëzoi një konfigurim të gabuar dhe doli vetë në internet. Kompania pastaj e ndali punën e stërvitjes deri në fund të muajit, për të menduar dhe testuar mënyra të reja se si t'i mbajë modelet të mbyllura.
Dy javë para këtij vendimi, konkurrenti Anthropic filloi t'ua kufizojë qasjen në internetin e gjallë modeleve të veta më të reja. Të dyja lëvizjet erdhën pas muajsh incidentesh në të cilat modelet, derisa zgjidhnin detyra stërvitjeje, hynin në sisteme të jashtme duke kërkuar përgjigje, bashkëpunonin në forume të errëta dhe sajonin strategji ekzotike hakerimi.
Në postimin në blogun e saj kompania shkruan: „Bazuar në gjendjen aktuale të hulumtimeve për përputhjen, sistemeve të mbikëqyrjes dhe sigurisë së infrastrukturës së internetit, mendojmë se qasja e përgjegjshme është që stërvitja e modeleve më të avancuara të zhvillohet pa qasje në internet.“ Dhe më tej: „Duhet gjithmonë të mund ta parandalojmë që një model i avancuar të fitojë qasje të paautorizuar, arbitrare në internetin e gjallë.“
Kthesa është më e madhe se sa tingëllon. Punonjësit në laboratorët kryesorë deri tani pohonin se një izolim i tillë është pothuajse i pazbatueshëm. Ish-hulumtuesi i OpenAI, Steven Adler, këtë muaj deklaroi se ndarja e qendrave të të dhënave nga interneti do të kërkonte që ekipet hulumtuese „praktikisht të vendosen në qendrat e të dhënave në Ajova ose kudo në botë“. Sipas tij, nuk është e qartë nëse përfitimi i sigurisë e justifikon atë „taksë“ kur një kompani e paguan vetëm.
Një inxhinier sigurie i OpenAI, që shkruan anonimisht në X, në shtator u ankua se nën pothuajse çdo postim të tij merr pesë deri në dhjetë komente pse thjesht nuk e shkëputin modelin nga interneti. Shpjegimi që dha: stërvitjet kërkojnë qasje në një mori mjetesh dhe burimesh, ndërsa mjediset e stërvitjes i ndërtojnë, i ndryshojnë dhe i testojnë mijëra hulumtues. „Pra, a është kaq e lehtë thjesht ta vendosësh në sandbox? Jo, nuk është.“
Çfarë e detyroi kompaninë të ndryshojë mendje? OpenAI lëshoi tufa të tëra agjentësh në ushtrime në të cilat duhej të përpiqeshin të iknin nga sandbox-i i tyre. Të çarat që gjetën mjaftuan që laboratori ta ndryshojë qasjen. Tani modelet do të punojnë me „një koleksion të madh përmbajtjeje uebi të indeksuar dhe të ruajtur“ - një kopje të internetit në të cilën mund të gërmojnë pa prekur sistemet e të tjerëve.
Nëse interneti i mbyllur, i ruajtur do të japë modele më të mira apo më të këqija se ato që endën lirshëm nëpër rrjet, mbetet të shihet. Por thelbi është tjetër: dy laboratorët kryesorë të IA-së pranuan zyrtarisht se teknologjia e tyre më e fuqishme nuk guxon të lihet pa mbikëqyrje në internetin publik. E pikërisht këto kompani çdo ditë na shesin agjentë IA që duhet të punojnë në emrin tonë në internet. Nëse nuk u besojnë ata që i bëjnë modelet, pse do t'u besonim ne?
Lajmet e fundit 10 lajme nga kjo kategori

Shtatë ditë për skanim, pastaj një vit pa plan familjar. Spotify e quan përmirësim rutinor, ndërsa për ata që ndajnë...
Dy dobësi kritike në PHP, të zbuluara me ndihmën e inteligjencës artificiale, i detyruan Finlandën, Holandën dhe institucionet britanike të...
Kompania tashmë flet për „superinteligjencë mjekësore“. Shifrat janë nga një simulim, pjesën më të madhe të përparimit e sjellin modelet...

Pony.ai jep automjetet, Nvidia çipat, ndërsa Kazakistani borën dhe akullin. Robotaksi nuk është më histori vetëm e SHBA-së dhe Kinës...
Të ardhurat u rritën 26 për qind, shpenzimet 68. Zgjidhja është një klasë e re aksionesh: investitorët sjellin para, ndërsa...
Paguan taksë pastrimi, pastaj në largim merr një listë detyrash. Për rezervimet nga 20 nëntori kjo përfundon, ndërsa një pjesë...
Kompania që shet inteligjencë artificiale tani ofron edhe ligjin që do ta kontrollonte. Kontrolluesit do t'i paguanin vetë laboratorët -...
TikTok nuk zhvillonte anketa për moshën e përdoruesve, nga frika se rezultatet do të duhej t'ia tregonte rregullatorit amerikan. Nëse...
Nvidia nuk fitoi vetëm me çipa, por me softuerin rreth tyre. Amazon tani e sulmon pikërisht atë mur dhe thotë...
Apple thotë se vjet shqyrtimi në App Store ndaloi mbi 150.000 aplikacione. Si kaluan atëherë nëpër të njëjtën derë aplikacionet...
Kjo faqe përdor cookies - a është në rregull? Mëso më shumë
Ji i pari që merr vesh kur Metla nxjerr diçka të re
Lëre e-mailin tënd dhe do të të shkruajmë kur ka një udhëzues të ri ose diçka të re në Metla.