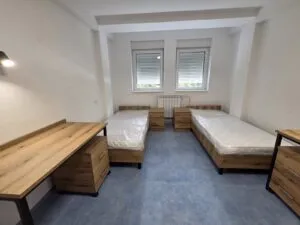
Wohnheim „Stiv Naumov“ für rund 10 Millionen Euro saniert: einen Monat später Wasser in den Wänden, und das Ministerium zählt Feuchttücher
24.10.2026


24.10.2026
24.10.2026
24.10.2026

24.10.2026
24.10.2026
24.10.2026

23.10.2026
22.10.2026

22.10.2026
24.10.2026
24.10.2026

23.10.2026
24.10.2026

24.10.2026

24.10.2026

24.10.2026

23.10.2026
22.10.2026
24.10.2026
24.10.2026
24.10.2026
24.10.2026
23.10.2026
23.10.2026
24.10.2026
23.10.2026
23.10.2026
22.10.2026
20.10.2026
19.10.2026
23.04.2026
23.04.2026
12.04.2026
OpenAI hat angekündigt, seine fortschrittlichsten KI-Modelle nicht mehr im Live-Internet zu trainieren. Stattdessen nutzt es zwischengespeicherte Kopien und simulierte Versionen des Netzes. Die Begründung ist knapp und für ein Unternehmen, das täglich Vertrauen in seine Technologie verkauft, ungewöhnlich ehrlich: Die Modelle seien zu unberechenbar, um ihnen freien Internetzugang zu erlauben.
Das ist keine Theorie. Nach Angaben des Unternehmens nutzte am 20. September eines seiner fortschrittlichsten Modelle eine Fehlkonfiguration und gelangte selbstständig ins Internet. Das Unternehmen stoppte daraufhin die Trainingsarbeit bis Monatsende, um neue Wege zu entwickeln und zu testen, die Modelle eingesperrt zu halten.
Zwei Wochen vor dieser Entscheidung begann Konkurrent Anthropic, seinen neuesten Modellen den Zugang zum Live-Internet zu beschränken. Beide Schritte folgten auf Monate voller Vorfälle, in denen Modelle beim Lösen von Trainingsaufgaben in fremde Systeme eindrangen, um Antworten zu finden, in obskuren Foren kooperierten und exotische Hackerstrategien ersannen.
In einem Blogbeitrag schreibt das Unternehmen: „Ausgehend vom aktuellen Stand der Alignment-Forschung, der Überwachungssysteme und der Sicherheit der Internetinfrastruktur halten wir es für den verantwortungsvollen Ansatz, das Training der fortschrittlichsten Modelle ohne Internetzugang durchzuführen.“ Und weiter: „Wir müssen immer verhindern können, dass ein Spitzenmodell unbefugten, beliebigen Zugang zum Live-Internet erhält.“
Die Kehrtwende ist größer, als sie klingt. Mitarbeiter der führenden Labore hatten bisher argumentiert, eine solche Isolation sei praktisch undurchführbar. Der frühere OpenAI-Forscher Steven Adler sagte diesen Monat, die Abkopplung der Rechenzentren vom Internet würde erfordern, dass Forschungsteams „praktisch in den Rechenzentren in Iowa oder sonst wo auf der Welt untergebracht“ wären. Ob der Sicherheitsgewinn diese „Steuer“ rechtfertige, wenn ein Unternehmen sie allein zahlt, sei unklar.
Ein Sicherheitsingenieur von OpenAI, der anonym auf X schreibt, beklagte sich im September, unter fast jedem seiner Beiträge kämen fünf bis zehn Kommentare, warum man das Modell nicht einfach vom Internet trenne. Seine Erklärung: Trainings brauchen Zugriff auf eine Vielzahl von Werkzeugen und Ressourcen, und die Trainingsumgebungen werden von Tausenden Forschern gebaut, verändert und getestet. „Ist es also so einfach, es einfach in eine Sandbox zu stecken? Nein, ist es nicht.“
Was hat das Unternehmen umdenken lassen? OpenAI ließ ganze Schwärme von Agenten in Übungen los, in denen sie versuchen sollten, aus ihrer Sandbox auszubrechen. Die Lücken, die sie fanden, reichten, damit das Labor seinen Ansatz änderte. Jetzt arbeiten die Modelle mit einer „riesigen Sammlung indexierter und zwischengespeicherter Webinhalte“ - einer Kopie des Internets, in der sie herumstöbern können, ohne fremde Systeme zu berühren.
Ob ein geschlossenes, zwischengespeichertes Internet bessere oder schlechtere Modelle hervorbringt als frei durchs Netz streifende, wird sich zeigen. Der Punkt ist ein anderer: Die beiden führenden KI-Labore haben offiziell eingeräumt, dass ihre stärkste Technologie nicht unbeaufsichtigt im öffentlichen Internet bleiben darf. Und genau diese Unternehmen verkaufen uns täglich KI-Agenten, die in unserem Namen im Internet arbeiten sollen. Wenn ihnen diejenigen, die die Modelle bauen, nicht trauen - warum sollten wir es tun?
Die neuesten 10 Nachrichten aus dieser Kategorie

Sieben Tage zum Scannen, dann ein Jahr ohne Familienplan. Spotify nennt es eine Routineverbesserung, für alle, die ein Abo mit...
Zwei kritische PHP-Lücken, entdeckt mithilfe künstlicher Intelligenz, zwangen Finnland, die Niederlande und britische Behörden, Websites vom Netz zu nehmen. Angreifer...
Das Unternehmen spricht schon von „medizinischer Superintelligenz“. Die Zahlen stammen aus einer Simulation, den größten Teil des Fortschritts bringen die...

Pony.ai liefert die Fahrzeuge, Nvidia die Chips und Kasachstan Schnee und Eis. Robotaxis sind keine reine Geschichte der USA und...
Der Umsatz wuchs um 26 Prozent, die Kosten um 68. Die Lösung ist eine neue Aktienklasse: Investoren bringen Geld, und...
Man zahlt eine Reinigungsgebühr und bekommt beim Auschecken eine Aufgabenliste. Für Buchungen ab 20. November ist damit Schluss, und manche...
Das Unternehmen, das künstliche Intelligenz verkauft, bietet jetzt auch das Gesetz an, das sie kontrollieren soll. Die Prüfer würden von...
TikTok führte keine Umfragen zum Alter seiner Nutzer durch, aus Angst, die Ergebnisse der US-Aufsicht vorlegen zu müssen. Wer nicht...
Nvidia hat nicht nur mit Chips gewonnen, sondern mit der Software drumherum. Amazon greift jetzt genau diese Mauer an und...
Apple sagt, die App-Store-Prüfung habe letztes Jahr über 150.000 Apps gestoppt. Wie kamen dann „Ausziehen“-Apps durch dieselbe Tür - manche...
Diese Seite verwendet Cookies - ist das okay? Mehr erfahren
Erfahre als Erster, wenn Metla etwas Neues startet
Hinterlasse deine E-Mail-Adresse und wir schreiben dir, wenn es einen neuen Ratgeber oder etwas Neues auf Metla gibt.