Sechzehn Festnahmen in vierundzwanzig Stunden, alle wegen Drogen: Die Polizei arbeitet - aber woher kommen so viele Leute?
20.09.2026


20.09.2026
20.09.2026
20.09.2026
20.09.2026
20.09.2026
20.09.2026
20.09.2026
19.09.2026
18.09.2026
20.09.2026
20.09.2026
19.09.2026
20.09.2026
20.09.2026
20.09.2026
20.09.2026
19.09.2026
18.09.2026
20.09.2026
20.09.2026
20.09.2026
20.09.2026
20.09.2026
20.09.2026
20.09.2026
19.09.2026
18.09.2026
22.08.2026
20.08.2026
18.08.2026
23.04.2026
23.04.2026
12.04.2026
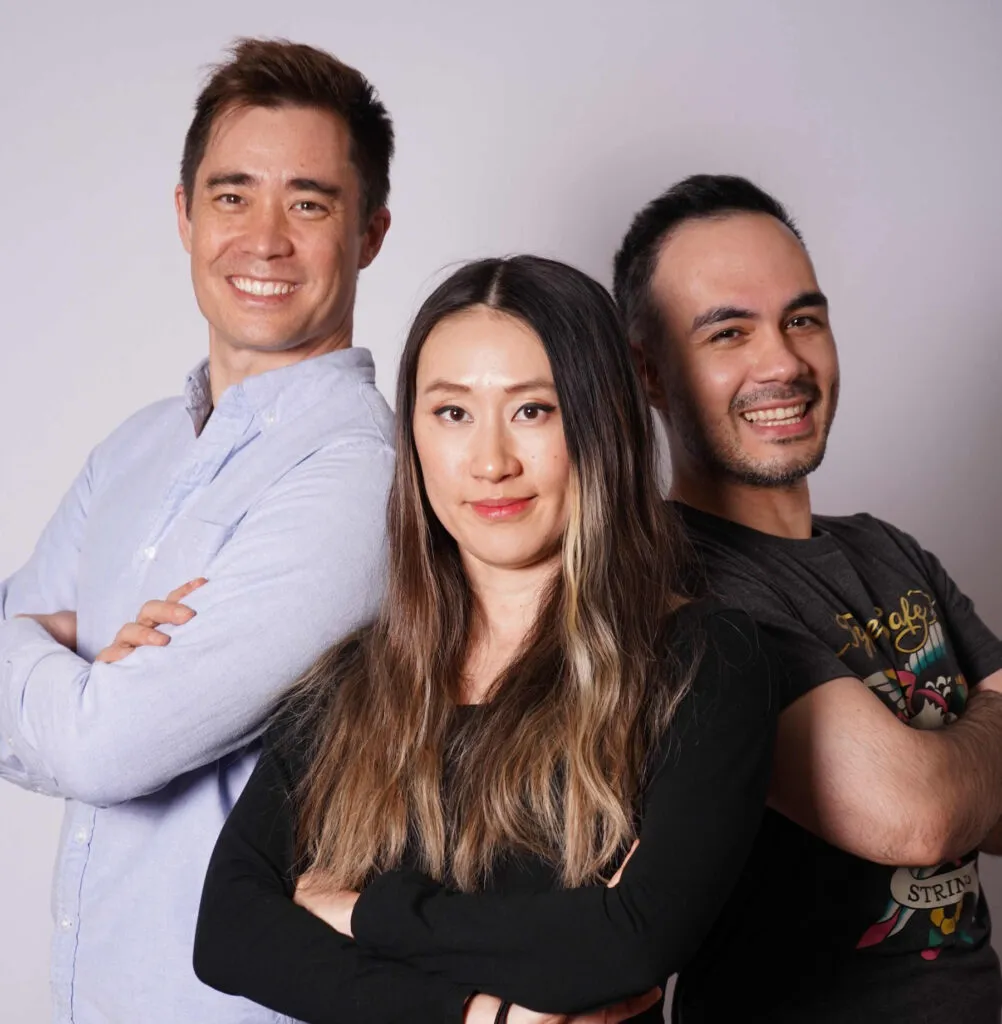
Der Mann, der mithalf, ChatGPT zu bauen, sagt jetzt, die gesamte Branche jage dem Falschen hinterher. Diogo Almeida, früher Forscher bei OpenAI und einer der Köpfe hinter dem Lernen aus menschlichem Feedback (RLHF) - der Methode, auf der fast alles beruht, was heute künstliche Intelligenz heißt - verließ das Unternehmen vor zwei Jahren, weil er mit dem, was er gebaut hatte, nicht zufrieden war.
„Wir haben den Blitz in der Flasche, und trotzdem ist er nicht nützlich“, sagte Almeida dem amerikanischen Technologieportal, das die Geschichte zuerst veröffentlichte. „Wir kämpfen seither mit diesem Problem. Ich brauchte Zeit für den Schluss: Das Problem ist, dass wir auf menschliche Sprache optimieren. Wir sind seit vier Jahren hervorragend in menschlicher Sprache, aber das nützt der Automatisierung nichts, weil Computer eine andere Sprache sprechen.“
Sein Start-up TypeSafe AI veröffentlichte diese Woche ein Modell namens Jev, das kein großes Sprachmodell ist. Es gibt keinen Text aus. Es gibt Wahrscheinlichkeiten aus - was das Unternehmen „kalibrierte Entscheidungen“ nennt. Der Nutzer definiert vorab die möglichen Ausgaben, das Modell hat also keinen Ort, eine neue zu erfinden. Damit, so die Firma, kann es buchstäblich nicht halluzinieren.
Der Effekt auf die Rechnung hat die Entwickler wachgerüttelt. Ausgabe-Token sind gratis, Eingabe-Token werden pro Milliarde gerechnet, nicht pro Million. Die Nachfrage war so groß, dass dem Unternehmen kurzzeitig die Kapazität fehlte, seine Nutzer über die Programmierschnittstelle zu bedienen.
Zahlen aus echtem Einsatz, nicht aus einer Marketingpräsentation. Pranit Sharma, Softwareingenieur bei Vercel, berichtet, seine Firma habe ein OpenAI-Modell genutzt, um zu prüfen, ob Befehle sicher sind. Nach dem Wechsel zu Jev kamen die Ergebnisse fünf- bis 18-mal schneller und mit höherer Genauigkeit. Nikhil Mudholkar, Technikchef von Bryo AI, testete Jev gegen Gemini zur Klassifizierung von Geschäftsnachrichten: Gemini war etwas genauer, aber 10- bis 20-mal teurer.
Was Mudholkar am meisten interessierte, war weder Geschwindigkeit noch Preis. „Es ist das einzige, das eine echte Wahrscheinlichkeit zurückgibt, was es ideal für die Automatisierung von Arbeitsabläufen macht“, sagt er. Armin Ronacher, Technikchef von Earendil, erklärt dasselbe von der anderen Seite: „Letztlich schiebt es das Halluzinationsproblem teilweise dem Nutzer zu. Der Nutzer muss sagen - gut, wenn das mit 50 Prozent Wahrscheinlichkeit zurückkommt, ist es vielleicht ein Münzwurf und ich ignoriere es. Aber wenn es 95 Prozent sind, dann kann ich etwas damit anfangen.“
Das ist ein ehrlicheres Geschäft als das, was die Branche derzeit bietet. Ein großes Sprachmodell liefert einen mit perfekter Selbstsicherheit geschriebenen Satz zurück, ohne Angabe, wie sehr es sich selbst glaubt. Jev liefert eine Zahl und überlässt Ihnen die Entscheidung, ob sie reicht. Es ist nicht intelligenter - aber überprüfbarer.
Der Name ist kein Zufall. Das Modell ist nach William Stanley Jevons benannt, dem Ökonomen des 19. Jahrhunderts, dessen Paradox besagt, dass wir von etwas, das billiger wird, ein Vielfaches mehr verbrauchen und nicht weniger. Genau darauf wettet Almeida: Wird Intelligenz billig genug, landet sie überall. „Wir glauben, es wird überall smarte Software geben, auf eine verteilte, gestreute Weise - viel mehr wie das frühe Internet als wie die Mega-Apps, die Leute gerade zu bauen versuchen“, sagt er.
Über die Architektur des Modells schweigt er, und externe Beobachter nehmen an, dass darunter doch ein Sprachmodell mit offenen Gewichten steckt. Was er einräumt: Jev wurde ausschließlich mit synthetischen Daten trainiert - Daten, die die Firma selbst erzeugte. „Wir haben früh darauf gesetzt, all unsere Daten selbst zu erzeugen, und das ist eine der besten Wetten meines Lebens - besser als unser Launch, besser als RLHF“, sagt der Mann, der RLHF erfand.
Auf die Frage, ob TypeSafe ein neues Frontier-Labor sei, antwortete Almeida mit einem Satz, der mehr wert ist als die gesamte PR der Branche in diesem Jahr: „Das Hauptprodukt der Frontier-Labore ist Angst oder Hype. Ich hätte gern, dass unser Hauptprodukt Intelligenz ist. Wir sind kein Labor im Sinne von - Sie wissen schon - einer Wette auf unendlichen Reichtum, oder einer Religion, oder dem Bau eines Gottes im Rechenzentrum, oder was auch immer gerade das Ding des Tages ist.“
Vorerst ist Jev einzigartig, doch Ronacher erwartet Konkurrenz, sobald klar wird, wozu es dient. Seine Erklärung, warum das nicht früher geschah, ist vielleicht der treffendste Satz über den Zustand des Marktes: „Wir hätten das in vielerlei Hinsicht früher sehen müssen, aber wahrscheinlich weil Sprachmodelle so billig und subventioniert sind, muss man oft immer noch nicht kreativ sein.“ Wenn fremdes Geld die Rechnung deckt, sucht niemand den billigeren Weg.
Die neuesten 10 Nachrichten aus dieser Kategorie
Eine neue Bundesbehörde, ein Beamter, den man schon KI-Zar nennt, und eine Bewerbungsbedingung - ein hoher Intelligenzquotient. Aufsicht, die vorab...
Kein lebender Schauspieler kann 75 Interviews auf einmal geben - und genau deshalb war die Zahl die Werbung. Doch dieselbe...
Dario Amodei warb monatelang für unabhängige Prüfer innerhalb der KI-Labore. Die Wahl fiel auf die größte Beratung der Welt statt...
Ein Analyst ließ das Werkzeug geheime und offene Daten verbinden - es verwechselte die Ladung des Schiffs. Dann verpackte dasselbe...
Wenn ein Modell lügen lernt und dieselbe Firma, die es erwischt hat, entscheidet, wie viel wir davon sehen. Anthropic geht...
Der deutsche Regulierer verbrachte Jahre mit einer Untersuchung, damit ein Bildschirm geändert wird. Die Frage ist nicht, ob die Regel...
Drei Tage, um das bislang am besten ausgerichtete Modell zu prüfen: Die Prüfer wollen ein Gesetz, keinen Essay der Chefs.
Das Gerät, das Spott erntete und den Aktienkurs abstürzen ließ, kehrt mit künstlicher Intelligenz, Partnern und einer App fürs Basketballwerfen...
Ein Forscher kündigte mit den Worten, die Branche spiele mit unseren Leben. Eine Warnung kann aufrichtig sein und zugleich den...
Kostenlos war es, solange die Firma wollte, dass Sie das Werkzeug nutzen. Jetzt, da Sie es nutzen, beginnt der Tarif...
Diese Seite verwendet Cookies - ist das okay? Mehr erfahren
Erfahre als Erster, wenn Metla etwas Neues startet
Hinterlasse deine E-Mail-Adresse und wir schreiben dir, wenn es einen neuen Ratgeber oder etwas Neues auf Metla gibt.